مقدمه: RAG چیست و چرا همه درباره آن صحبت میکنند؟
راهنمای جامع RAG | فرض کنید در شرف شرکت در یک امتحان بازکتاب (open book) هستید. تمام حقایق را حفظ نیستید، اما یک کتاب درسی و یادداشتهایی در کنار خود دارید. وقتی سوالی مطرح میشود، بخشهای مرتبط را مرور میکنید، مطلب را میخوانید و پاسخ خود را بر اساس آن منبع مینویسید. شما چیزی را از خود نمیسازید؛ پاسخ خود را در منبع معتبر ریشهدار میکنید.
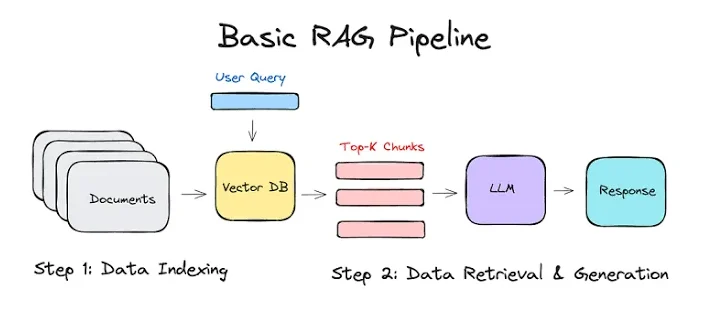
این دقیقاً کاری است که RAG یا Retrieval-Augmented Generation برای یک مدل زبانی بزرگ انجام میدهد.
یک مدل زبانی بزرگ مانند GPT، Claude یا Gemini مانند دانشآموزی است که فقط آنچه را در دوران آموزش حفظ کرده در اختیار دارد. این مدلها باهوش هستند. استدلال میکنند. مینویسند و توضیح میدهند، اما دانش آنها تاریخ انقضا دارد و مهمتر از آن، هیچ اطلاعی از اسناد شما، پایگاههای داده شرکت شما و دانش داخلی سازمان شما ندارند.
داشتن یک معماری RAG این مشکل را برطرف میکند. به جای تکیه صرف بر آنچه مدل حفظ کرده، RAG به مدل توانایی جستجوی اطلاعات را میدهد و سپس پاسخی تولید میکند که در متن بازیابیشده ریشه دارد.
RAG در حقیقت دو چیز است که با هم کار میکنند: یک سیستم بازیابی که اطلاعات مناسب را پیدا میکند و یک سیستم تولید که همان LLM شماست و از آن اطلاعات برای پاسخدهی هوشمندانه استفاده میکند.
سیستم های RAG ترفند جالب نیست؛ بنیاد تقریباً تمام اپلیکیشنهای جدی هوش مصنوعی در سطح سازمانی است که امروزه ساخته میشوند. از رباتهای پشتیبانی مشتری گرفته تا دستیارهای دانش داخلی و تحلیل اسناد حقوقی — RAG زیر تمام این موارد کار میکند.
دو باور غلط رایج درباره RAG
افسانه اول: «RAG مرده است!»
این ادعا را زیاد میشنوید. اتفاقی که افتاد این بود که چند مقاله نشان دادند مدلهای زبانی بزرگ حتی با وجود متن بازیابیشده هم ممکن است توهم (hallucination) داشته باشند و برخی این روایت را پیش بردند که RAG شکست خورده است.
اما واقعیت این است: RAG یک فناوری واحد نیست؛ یک الگوی معماری است که باید به تکامل خود ادامه دهد. الگوهایی که در ادامه معرفی میکنیم — مانند Corrective RAG، Self-RAG و Agentic RAG — همگی پاسخ مستقیمی به محدودیتهای اولیه RAG هستند. RAG نمرده، در حال بلوغ است.
افسانه دوم: «با هوش مصنوعی ارزان ، دیگر نیازی به RAG نداریم!»
این باور گیجکننده است چون در ظاهر منطقی به نظر میرسد: «اگر بتوانم یک میلیون توکن را در پرامپت خود بریزم، چرا اصلاً سیستم بازیابی بسازم؟»
دلایل متعددی وجود دارد که این ایده در عمل جواب نمیدهد:
هزینه: پردازش یک میلیون توکن در هر کوئری در مقیاس بزرگ، بهشدت گران است.
تأخیر (Latency): این فراخوانها بسیار کند خواهند بود.
کاهش دقت: تحقیقات نشان میدهد که مدلهای زبانی بزرگ وقتی با متنهای نامربوط پر میشوند، دقت خود را از دست میدهند. یک سیستم RAG خوب دقیقاً اطلاعات درست را سطحبندی میکند و در دقت، هزینه و سرعت، عملکردی بسیار بهتر از پر کردن بیرویه زمینه دارد.
راهنمای جامع معماری RAG: اجزای اصلی
درک عمیق هر مؤلفه، چیزی است که توسعهدهندگانی را که سیستمهای RAG کارآمد میسازند از کسانی که سیستمهای ناکارآمد میسازند جدا میکند.
مرحله ۱: دریافت اطلاعات (Ingestion)
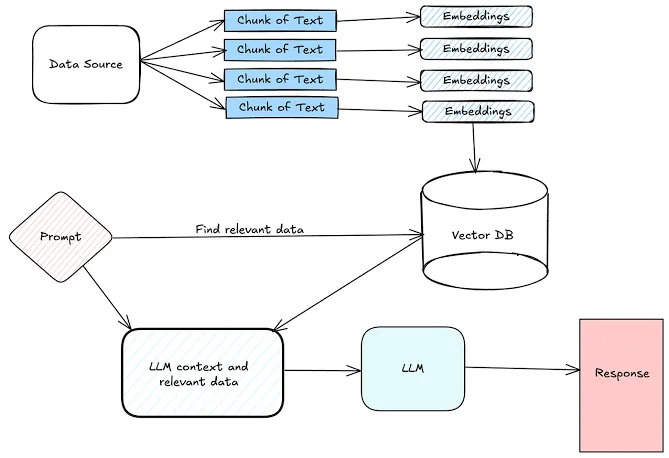
پیش از هر بازیابی، اسناد شما باید به قطعات کوچکتر شکسته شده و ذخیره شوند. به این فرآیند Chunking یا قطعهبندی میگویند.
روش ساده: قطعهبندی با اندازه ثابت (Fixed-Size Chunking)
هر سند را به قطعات مثلاً ۵۰۰ توکنی تقسیم میکنید.
گاهی کار میکند اما زمینه را در مرزهای قطعه از دست میدهد. اگر یک جمله بین دو قطعه نصف شود، هیچکدام مفهوم درستی ندارند.
روش بهتر: قطعهبندی معنایی (Semantic Chunking)
از یک مدل embedding برای تشخیص محل تغییر موضوع در متن استفاده میکنید و در آن مرزهای طبیعی قطعهبندی میکنید.
ابزارهایی مانند LangChain و LlamaIndex پشتیبانی داخلی از این روش دارند.
روش پیشرفتهتر: قطعهبندی سلسلهمراتبی (Hierarchical Chunking)
هم یک قطعه کوچک و دقیق و هم یک قطعه والد بزرگتر که زمینه بیشتری به آن میدهد ذخیره میکنید.
وقتی قطعه کوچک بازیابی میشود، قطعه والد را نیز به LLM میدهید. این تکنیک Small-to-Big Retrieval نام دارد و یکی از بهترین روشها در RAG تولیدی است.
مرحله ۲: مدلهای Embedding
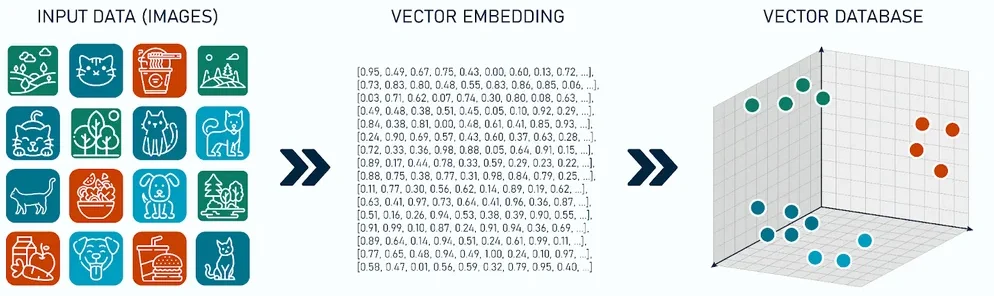
پس از قطعهبندی، هر قطعه را به یک embedding (بردار عددی) تبدیل میکنید که معنای آن متن را نمایش میدهد. وقتی کاربر سوالی میپرسد، کوئری او را نیز embedding میکنید و سپس قطعاتی را پیدا میکنید که embedding آنها به embedding کوئری نزدیکتر باشد. این همان جستجوی معنایی است.
مدلهای برتر embedding در سال ۲۰۲۶:
| مدل | ابعاد | ویژگی کلیدی |
|---|---|---|
| Gemini Embedding 2 | ۳۰۷۲ | پشتیبانی از متن، تصویر، ویدئو، صدا و PDF |
| Voyage-3-large | ۱۰۲۴ | حداکثر ۳۲۰۰۰ توکن |
| OpenAI text-embedding-4 | ۴۰۹۶ | کیفیت بالا برای متون انگلیسی |
| BGE-M3 | ۵۶۷M پارامتر | پشتیبانی از ۱۰۰+ زبان و جستجوی هیبرید |
| Qwen3-Embedding-8B | ۳۲-۴۰۹۶ | رتبه ۱ در MTEB، پشتیبانی از ۳۲K توکن |
توصیه مهم: مدلهای embedding را بر اساس دامنه خاص خود بنچمارک کنید، چون عملکرد مدلها در حوزههای مختلف بهشدت متفاوت است. مدلی که روی متون حقوقی عالی است ممکن است روی مستندات کد عملکرد متوسطی داشته باشد.
مرحله ۳: پایگاههای داده برداری (Vector Databases)
اینجا جایی است که embeddingها ذخیره میشوند. بازیگران اصلی این حوزه عبارتند از:
Pinecone: مدیریتشده، بدون متنباز
Weaviate: مدیریتشده + خودمیزبانی، متنباز
Milvus / Zilliz: مدیریتشده + خودمیزبانی، متنباز
Qdrant: مدیریتشده + خودمیزبانی، متنباز
Chroma: خودمیزبانی / محلی، متنباز
TiDB Vector Search: مدیریتشده + خودمیزبانی، متنباز
معیارهای انتخاب:
تأخیر کوئری در مقیاس مورد انتظار شما
پشتیبانی از فیلتر کردن متادیتا (بر اساس تاریخ، منبع، دستهبندی)
پشتیبانی از جستجوی هیبرید (ترکیب جستجوی برداری و کلیدواژهای)
مرحله ۴: استراتژیهای بازیابی
جستجوی برداری خالص (پیدا کردن قطعات از نظر معنایی مشابه) عالی است اما کامل نیست. سیستمهای پیشرفته امروزی از جستجوی هیبرید استفاده میکنند . ترکیبی از روشهای کلیدواژهای مانند BM25 و مدلهای برداری متراکم. روشهای کلیدواژهای در تطابق دقیق عالی هستند اما درک معنایی ندارند، در حالی که مدلهای برداری متراکم زمینه را درک میکنند اما در دقت و اختصاصیبودن ضعف دارند. ترکیب این دو، محدودیتهای هرکدام را پوشش میدهد.
۱۰ الگوی پیشرفته RAG که باید در سال ۲۰۲۶ بشناسید
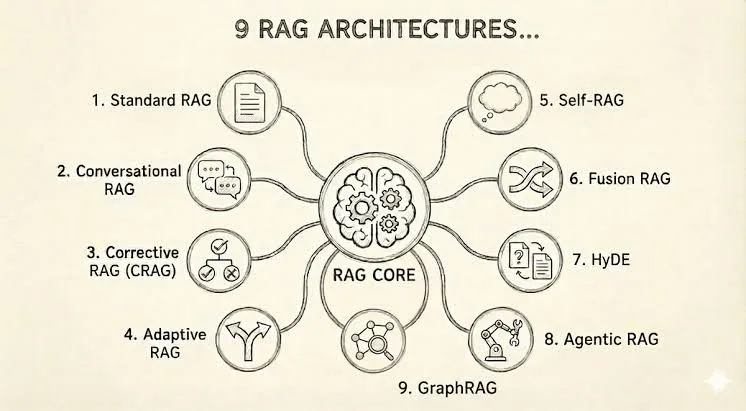
این ۱۰ معماری متفاوت هستند که هرکدام مسئله خاصی را حل میکنند.
۱. Simple RAG (ساده)
سادهترین شکل: سوال میپرسید، قطعات مرتبط را بازیابی میکنید، آنها را در پرامپت میریزید و LLM پاسخ میدهد. Hello World دنیای RAG است. برای نمونهسازی اولیه خوب است اما برای تولید (Production) کافی نیست.
۲. RAG with Memory (با حافظه)
یک لایه حافظه روی Simple RAG اضافه میکند تا بتواند مکالمات قبلی را به خاطر بیاورد و پاسخهای زمینهدارتری بدهد.
۳. Branched RAG (شاخهای)
گاهی یک کوئری برای پاسخ به یک سوال پیچیده کافی نیست. Branched RAG از یک LLM استفاده میکند تا سوال کاربر را به چند زیرسوال تجزیه کند، برای هرکدام بهطور موازی بازیابی انجام دهد و سپس نتایج را در یک پاسخ منسجم ترکیب کند.
۴. HyDE (Hypothetical Document Embedding)
این الگو بسیار هوشمندانه است. مشکلی که حل میکند این است که embedding کوئری و embedding اسناد معمولاً حتی وقتی درباره یک چیز صحبت میکنند، متفاوت به نظر میرسند. یک سوال درباره «علت تورم» از نظر embedding با یک پاراگراف که تورم را توضیح میدهد، تفاوت دارد.
HyDE این فاصله را با اول asking از LLM برای تولید یک پاسخ فرضی به کوئری — حتی پیش از بازیابی — پر میکند. سپس آن پاسخ فرضی را embedding کرده و از آن به عنوان بردار جستجو استفاده میکند، چون پاسخ فرضی بسیار بیشتر شبیه یک سند واقعی است. کیفیت بازیابی بهطور قابلتوجهی بهبود مییابد.
۵. Adaptive RAG (تطبیقی)
همه سوالات نیازی به بازیابی ندارند. اگر کاربر بپرسد «۲ به علاوه ۲ چند میشود؟»، نیازی به مراجعه به پایگاه داده برداری نیست. Adaptive RAG از یک لایه مسیریابی استفاده میکند — یک طبقهبند سبک یا یک فراخوانی LLM — که تصمیم میگیرد:
آیا سوال اصلاً به بازیابی نیاز دارد؟
آیا به بازیابی ساده نیاز دارد یا به بازیابی چندمرحلهای پیچیدهتر؟
این کار سیستم را هوشمندتر و هزینه را کمتر میکند.
۶. Corrective RAG (CRAG)
این الگو مستقیماً به یک حالت شکست واقعی پاسخ میدهد: چه اتفاقی میافتد وقتی اسناد بازیابیشده کیفیت پایینی دارند یا کاملاً نامربوط هستند؟
Corrective RAG یک مرحله ارزیابی پس از بازیابی اضافه میکند. اگر اسناد بازیابیشده امتیاز低于 آستانه اطمینان باشند، سیستم یا کوئری را دوباره فرموله کرده و دوباره تلاش میکند یا به جستجوی وب بازمیگردد تا اطلاعات بهتری پیدا کند.
۷. Self-RAG
Self-RAG ایده خوداصلاحی را جلوتر میبرد. خود LLM آموزش داده میشود یا پرامپت میشود تا توکنهای بازتابی خاصی را هنگام نوشتن پاسخ تولید کند، مانند:
«آیا بازیابی در اینجا لازم است؟»
«آیا این قطعه واقعاً مرتبط است؟»
«آیا این ادعا توسط متن بازیابیشده پشتیبانی میشود؟»
مدل استدلال خود را در لحظه نقد میکند. نتیجه پاسخی است که زمینهدارتر، دقیقتر و شفافتر درباره سطح اطمینان خود است.
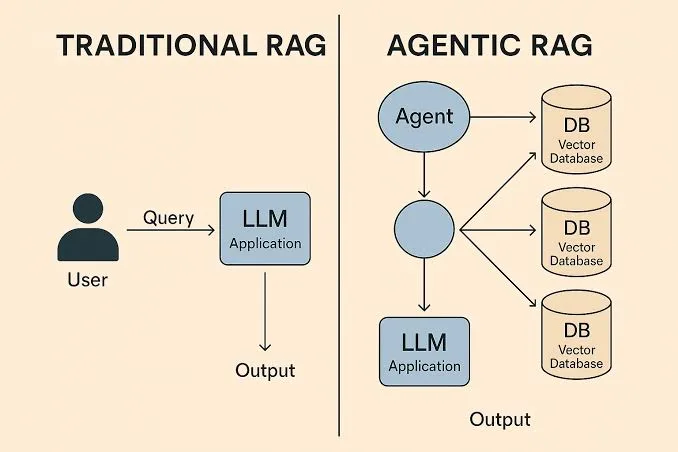
۸. Agentic RAG (عاملی)
اینجا جایی است که RAG با عاملهای هوش مصنوعی برخورد میکند و جهتی است که کل حوزه به سمت آن در حرکت است.
به جای یک مرحله «بازیابی سپس تولید»، Agentic RAG از یک LLM به عنوان هماهنگکننده (Orchestrator) استفاده میکند که میتواند تصمیم بگیرد بعداً چه کاری انجام دهد:
آیا نیاز به جستجوی اطلاعات بیشتر دارد؟
آیا باید API خاصی را فراخوانی کند؟
آیا باید کدی اجرا کند؟
- آیا باید از منبع دیگری بازیابی کند؟
آیا به اندازه کافی زمینه برای پاسخدهی دارد؟
این فرآیند تا زمانی که پاسخ به اندازه کافی خوب شود ادامه مییابد. Agentic RAG «بازیابی دانش را به یک جریان کاری فعال تبدیل میکند».
در سال ۲۰۲۶، RAG از یک خط لوله ساده «بازیابی-بعد-تولید» به یک زمان اجرای دانش (Knowledge Runtime) جامع تبدیل شده است — لایهای که بازیابی، استدلال، راستیآزمایی و حاکمیت را بهعنوان عملیات یکپارچه مدیریت میکند.
۹. Multimodal RAG (چندوجهی)
بیشتر سیستمهای RAG فقط متن را مدیریت میکنند، اما دادههای دنیای واقعی شما شامل نمودارها، جداول، تصاویر و PDFهای با محتوای ترکیبی است.
Multimodal RAG همه اینها را مدیریت میکند:
از یک مدل زبان-بینایی (Vision Language Model) برای تولید توضیحات متنی برای تصاویر و جداول در زمان ورود داده استفاده میکند تا بتوانند مانند سایر قطعات embedding و بازیابی شوند.
یا حتی فراتر رفته و embedding تصاویر را مستقیماً در کنار embedding متون ذخیره میکند.
با غنیتر و بصریتر شدن دادههای سازمانی، Multimodal RAG ضروریتر خواهد شد.
۱۰. Graph RAG
این یکی از جالبترین تحولات اخیر است. RAG استاندارد، پایگاه دانش شما را بهعنوان مجموعهای تخت از قطعات در نظر میگیرد — هیچ رابطهای بین آنها وجود ندارد.
Graph RAG یک گراف دانش روی اسناد شما میسازد و موجودیتها و روابط آنها را بهطور صریح نقشهبرداری میکند. وقتی سوالی نیاز به اتصال چندین قطعه اطلاعات دارد — مانند «این مقررات چگونه بر قراردادهایی که با این سه فروشنده امضا کردهایم تأثیر میگذارد؟» — Graph RAG عملکردی بهمراتب بهتر از جستجوی برداری استاندارد دارد، چون رابطه را درک میکند و نه فقط شباهت را.
جمعبندی راهنمای جامع RAG : آینده RAG
RAG در سال ۲۰۲۶ دیگر یک تکنیک ساده نیست. همانطور که دیدیم، این معماری از یک «بازیابی-سپس-تولید» ساده به سیستمهای پویا، خوداصلاحشونده و عاملی تبدیل شده است که میتوانند استدلال چندمرحلهای، مدیریت پویای حافظه و استراتژیهای بازیابی تکراری را هماهنگ کنند.
بازار RAG نیز با نرخ رشد مرکب سالانه ۴۱٪ در حال رشد است و از ۲٫۱۱ میلیارد دلار در سال ۲۰۲۵ به ۲٫۹۸ میلیارد دلار در سال ۲۰۲۶ خواهد رسید.
پیام کلیدی: برندگان هوش مصنوعی سازمانی، شرکتهایی با بزرگترین مدلها نیستند؛ شرکتهایی هستند که عاملهای هوش مصنوعی را به معتبرترین، حاکمیتشدهترین و عملیترین دادههای خود متصل میکنند